• SVM(Support Vector Machine):支持向量机
  • SVC(Support Vector Classifier):支持向量分类器
  • SVR(Support Vector Regression):支持向量回归器

支持向量机基本型

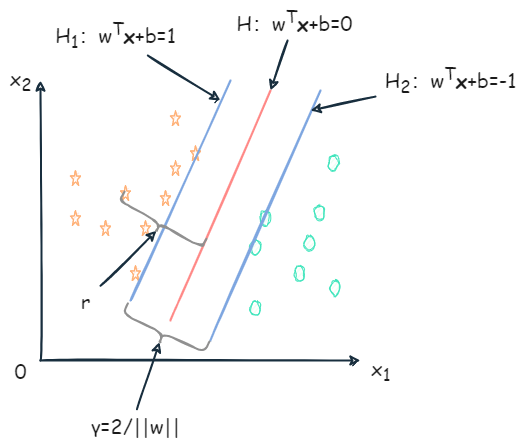
给定大小为 mm 的训练集 D={(x1,y1),(x2,y2),…,(xm,ym)},yi∈{−1,1}D=\{(\mathbf{x}_1, y_1), (\mathbf{x}_2, y_2), \ldots, (\mathbf{x}_m, y_m)\},y_i\in\{-1, 1\}。基于训练集 DD 在样本空间中找到一个超平面,将不同类别的样本分开,如下图:

划分超平面

明显红色的划分超平面更合适。划分超平面可通过线性方程描述:

wTx+b=0w^T\mathbf{x}+b=0

  • w=(w1,w2,…,wn)w=(w_1, w_2, \ldots, w_n):为法向量,决定了超平面的方向;
  • bb:位移项。
  • x=(x1,x2,…,xn)\mathbf{x}=(\mathbf{x}_1, \mathbf{x}_2, \ldots,\mathbf{x}_n)

样本空间中任意点到超平面 (w,b)(w,b) 的距离为:

r=∣wTx+b∣∣∣w∣∣r=\frac{\vert w^T\mathbf{x}+b\vert}{\vert\vert w\vert\vert}

在做分类时,应有 (xi,yi)∈D(\mathbf{x}_i, y_i)\in D,当 yi=+1y_i=+1 时,wTxi+b>0w^T\mathbf{x}_i+b>0;当 yi=−1y_i=-1 时,wTxi+b<0w^T\mathbf{x}_i+b<0。令:

{wTxi+b≥+1,yi=+1wTxi+b≤−1,yi=−1\begin{cases} w^T\mathbf{x}_i+b\geq+1, y_i=+1\\ w^T\mathbf{x}_i+b\leq-1, y_i=-1 \end{cases}

距离超平面最近的几个训练样本点满足上式,如下图 H1H_1、H2H_2 上的样本被称为支持向量(support vector)。

支持向量

两个异类的支持向量到超平面的距离之和(也称为间隔)为:

γ=∣(b+1)−(b−1)∣∣∣w∣∣=2∣∣w∣∣\gamma=\frac{\vert(b+1)-(b-1)\vert}{\vert\vert w\vert\vert}=\frac{2}{\vert\vert w\vert\vert}

为了找到具有最大间隔的划分超平面,需要满足下式中约束参数 ww 和b,使得 γ\gamma 最大:

max⁡w,b2∣∣w∣∣同时保证 yi(wTxi+b)≥1,i=1,2,…,m.\max_{w,b}\frac{2}{\vert\vert w\vert\vert}\\ 同时保证\ y_i(w^T\mathbf{x}_i+b)\geq 1,i=1,2,\ldots,m.

为了最大化间隔,需要最大化 ∣∣w∣∣−1\vert\vert w\vert\vert^{-1},等价于最小化 ∣∣w∣∣2\vert\vert w\vert\vert^2

min⁡w,b12∣∣w∣∣2同时保证 yi(wTxi+b)≥1,i=1,2,…,m.\min_{w,b}\frac{1}{2}\vert\vert w\vert\vert^2\\ 同时保证\ y_i(w^T\mathbf{x}_i+b)\geq 1,i=1,2,\ldots,m.

对上式使用拉格朗日乘子法可得到它的对偶问题。

  • 拉格朗日乘⼦法是⼀种寻找多元函数在⼀组约束下的极值的方法。

    • 通过引⼊拉格朗日乘子,可将有 dd 个变量与 kk 个约束条件的最优化问题转化为具有 d+kd+k 个变量的⽆约束优化问题求解。
  • 对上式每条约束添加拉格朗日乘子 αi≥0\alpha_i\geq 0

  • 对偶问题是原始问题的一种变换形式,它在数学上与原始问题密切相关,但可能具有不同的结构和性质。

L(w,b,α)=12∣∣w∣∣2+∑i=1mαi(1−yi(wTxi+b))L(w,b,\mathcal{\alpha})=\frac{1}{2}\vert\vert w\vert\vert^2+\sum_{i=1}^m\alpha_i(1-y_i(w^T\mathbf{x}_i+b))

  • 其中 α=(α1,α2,…,αm)\mathcal{\alpha}=(\alpha_1, \alpha_2, \ldots, \alpha_m)

令 L(w,b,α)L(w,b,\mathcal{\alpha}) 对 ww 和 bb 的偏导为零,可得

∂L(w,b,α)∂w=w−∑i=1mαiyixi=0⇒w=∑i=1mαiyixi\frac{\partial L(w,b,\mathcal{\alpha})}{\partial w}=w-\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i=0\Rightarrow w=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i

∂L(w,b,α)∂b=−∑i=1mαiyi=0⇒0=∑i=1mαiyi\frac{\partial L(w,b,\mathcal{\alpha})}{\partial b}=-\sum_{i=1}^m\alpha_iy_i=0\Rightarrow 0=\sum_{i=1}^m\alpha_iy_i

将 w=∑i=1mαiyixiw=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i 代入 L(w,b,α)L(w,b,\mathcal{\alpha}),将 ww 和 bb 消去,再结合 0=∑i=1mαiyi0=\sum_{i=1}^m\alpha_iy_i,得到 min⁡w,b12∣∣w∣∣2\min_{w,b}\frac{1}{2}\vert\vert w\vert\vert^2 的对偶问题:

max⁡α∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjxiTxj(1)\max_{\mathcal{\alpha}}\sum_{i=1}^m\alpha_i-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jy_iy_j\mathbf{x}_i^T\mathbf{x}_j\tag{1}

同时保证 ∑i=1mαiyi=0,αi≥0,i=1,2,…,m.同时保证\ \sum_{i=1}^m\alpha_iy_i=0,\\ \alpha_i\geq0,i=1,2,\ldots,m.

求解出 α\mathcal{\alpha} 后:

f(x)=wTx+b=∑i=1mαiyixiTx+b(2)f(\mathbf{x})=w^T\mathbf{x}+b=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i^T\mathbf{x}+b\tag{2}

上述过程需满足 KKT 条件,即:

{αi≥0yif(x)−1≥0αi(yif(x)−1)=0\begin{cases} \alpha_i\geq 0\\ y_if(\mathbf{x})-1\geq 0\\ \alpha_i(y_if(\mathbf{x})-1)=0 \end{cases}

对任意训练样本 (xi,yi)(\mathbf{x}_i,y_i),总有 αi=0\alpha_i=0 或 yif(xi)=1y_if(\mathbf{x}_i)=1。

  • 若 αi=0\alpha_i=0,该样本不会出现在式 1 的求和中,也不会对 f(xi)f(\mathbf{x}_i) 产生影响。
  • 若 αi>0\alpha_i>0,则必有 yif(xi)=1y_if(\mathbf{x}_i)=1,对应的样本点位于最大间隔边界上,即支持向量。

训练完后,大部分训练样本也不需要保留,最终模型仅与支持向量有关。

SMO

对于式 1 的求解,可以使用二次规划算法求解,也可以通过 SMO(Sequential Minimal Optimization) 算法求解。

SMO 的基本思路:

  • 固定 αi\alpha_i 之外的所有参数,求 αi\alpha_i 上的极值。

  • 每次选择两个变量 αi\alpha_i 和 αj\alpha_j,同时固定其他参数,在参数初始化后,不断执行以下步骤直至收敛:

    • 选取一对需更新的变量 αi\alpha_i 和 αj\alpha_j;
    • 固定 αi\alpha_i 和 αj\alpha_j 以外的参数,求解式 1 获得更新后的 αi\alpha_i 和 αj\alpha_j 。

    SMO 使选取的两变量所对应样本之间的间隔最大。

    • 使得两个变量有很大区别,给目标函数值更大的变化。

核函数

上述讨论训练样本是线性可分的(即存在划分超平面能正确分类),如果原始样本空间内不能存在这样的划分超平面,那么需要 将样本从原始空间映射到更高维的空间,使其在这个特征空间内线性可分。

  • 令 ϕ(x)\phi(\mathbf{x}) 表示将 x\mathbf{x} 映射后的特征向量,则在特征空间中划分超平面所对应的模型表示为:

f(x)=wTϕ(x)+bf(\mathbf{x})=w^T\phi(\mathbf{x})+b

其中 ww 和 bb 为模型参数,有:

min⁡w,b12∣∣w∣∣2同时保证 yi(wTϕ(xi)+b)≥1, i=1,2,…,m\min_{w,b}\frac{1}{2}\vert\vert w\vert\vert^2\\ 同时保证\ y_i(w^T\phi(\mathbf{x}_i)+b)\geq 1,\ i=1,2,\ldots,m

其对偶问题是:

max⁡α∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjϕ(xi)Tϕ(xj)同时保证 ∑i=1mαiyi=0,αi≥0,i=1,2,…,m\max_\alpha\sum_{i=1}^m\alpha_i-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jy_iy_j\phi(\mathbf{x}_i)^T\phi(\mathbf{x}_j)\\ 同时保证\ \sum_{i=1}^m\alpha_iy_i=0,\alpha_i\geq 0,i=1,2,\ldots,m

设计核函数:

κ(xi,xj)=<ϕ(xi),ϕ(xj)>=ϕ(xi)Tϕ(xj)\kappa(\mathbf{x}_i, \mathbf{x}_j)=<\phi(\mathbf{x}_i),\phi(\mathbf{x}_j)>=\phi(\mathbf{x}_i)^T\phi(\mathbf{x}_j)

  • 即 xi\mathbf{x}_i 与 xj\mathbf{x}_j 在特征空间的内积等于它们在原始样本空间通过函数 κ(⋅,⋅)\kappa(\cdot,\cdot) 计算的结果。

所以之前的式子改写为:

max⁡α∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjκ(xi,xj)同时保证 ∑i=1mαiyi=0,αi≥0,i=1,2,…,m\max_\alpha\sum_{i=1}^m\alpha_i-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jy_iy_j\kappa(\mathbf{x}_i,\mathbf{x}_j)\\ 同时保证\ \sum_{i=1}^m\alpha_iy_i=0,\alpha_i\geq 0,i=1,2,\ldots,m

求解后可得到:

f(x)=wTϕ(x)+b=∑i=1mαiyiϕ(xi)Tϕ(x)+b=∑i=1mαiyiκ(xi,x)+bf(\mathbf{x})=w^T\phi(\mathbf{x})+b\\ =\sum_{i=1}^m\alpha_iy_i\phi(\mathbf{x}_i)^T\phi(\mathbf{x})+b\\ =\sum_{i=1}^m\alpha_iy_i\kappa(\mathbf{x}_i,\mathbf{x})+b

  • 上式说明模型最优解可通过训练样本的核函数展开,展式称为支持向量展式。

定理:令 χ\chi 为输入空间,κ(⋅,⋅)\kappa(\cdot,\cdot) 式定义在 χ×χ\chi\times\chi 上的对称函数,则 κ\kappa 式核函数 当且仅当 对于任意数据 D={x1,x2,…,xm}D=\{\mathbf{x}_1,\mathbf{x}_2,\ldots,\mathbf{x}_m\},核矩阵 KK 总是半正定的:

K=[κ(x1,x1)⋯κ(x1,xj)⋯κ(x1,xm)⋮⋱⋮⋱⋮κ(xi,x1)⋯κ(xi,xj)⋯κ(xi,xm)⋮⋱⋮⋱⋮κ(xm,x1)⋯κ(xm,xj)⋯κ(xm,xm)]K=\left[\begin{matrix} \kappa(\mathbf{x}_1,\mathbf{x}_1) & \cdots & \kappa(\mathbf{x}_1,\mathbf{x}_j) & \cdots & \kappa(\mathbf{x}_1,\mathbf{x}_m)\\ \vdots & \ddots & \vdots & \ddots & \vdots\\ \kappa(\mathbf{x}_i,\mathbf{x}_1) & \cdots & \kappa(\mathbf{x}_i,\mathbf{x}_j) & \cdots & \kappa(\mathbf{x}_i,\mathbf{x}_m)\\ \vdots & \ddots & \vdots & \ddots & \vdots\\ \kappa(\mathbf{x}_m,\mathbf{x}_1) & \cdots & \kappa(\mathbf{x}_m,\mathbf{x}_j) & \cdots & \kappa(\mathbf{x}_m,\mathbf{x}_m) \end{matrix}\right]

  • 对于一个半正定和矩阵,总能找到一个与之对应的映射 ϕ\phi。任何一个核函数都隐式定义了一个称为“再生核希尔伯特空间”(简称RKHS)的特征空间。

常用核函数如下:

  • 线性核:κ(xi,xj)=xiTxj\kappa(\mathbf{x}_i,\mathbf{x}_j)=\mathbf{x}_i^T\mathbf{x}_j;
  • 多项式核:κ(xi,xj)=(xiTxj)d\kappa(\mathbf{x}_i,\mathbf{x}_j)=(\mathbf{x}_i^T\mathbf{x}_j)^d,d≥1d\geq 1 为多项式的次数;
  • 高斯核:κ(xi,xj)=exp⁡(−∣∣xi−xj∣∣22σ2)\kappa(\mathbf{x}_i,\mathbf{x}_j)=\exp(-\frac{\vert\vert\mathbf{x}_i-\mathbf{x}_j\vert\vert^2}{2\sigma^2}),σ>0\sigma>0 为高斯核的带宽;
  • 拉普拉斯核:κ(xi,xj)=exp⁡(−∣∣xi−xj∣∣2σ2)\kappa(\mathbf{x}_i,\mathbf{x}_j)=\exp(-\frac{\vert\vert\mathbf{x}_i-\mathbf{x}_j\vert\vert^2}{\sigma^2}),σ>0\sigma>0;
  • Sigmoid核:κ(xi,xj)=tanh⁡(βxiTxj+θ)\kappa(\mathbf{x}_i,\mathbf{x}_j)=\tanh(\beta\mathbf{x}_i^T\mathbf{x}_j+\theta),tanh⁡\tanh 为双曲正切函数,β>0,θ<0\beta>0,\theta<0。

此外,核函数还可通过组合得到:

  • 若 κ1\kappa_1 和 κ2\kappa_2 为核函数,则对于任意正数 γ1、γ2\gamma_1、\gamma_2,其线性组合 γ1κ1+γ2κ2\gamma_1\kappa_1+\gamma_2\kappa_2 也是核函数。
  • 若 κ1\kappa_1 和 κ2\kappa_2 为核函数,则核函数的直积 κ1⊗κ2(xi,z)=κ1(xi,z)κ2(xi,z)\kappa_1\otimes\kappa_2(\mathbf{x}_i,\mathbf{z})=\kappa_1(\mathbf{x}_i,\mathbf{z})\kappa_2(\mathbf{x}_i,\mathbf{z}) 也是核函数。
  • 若 κ1\kappa_1 为核函数,则对于任意函数 g(x)g(x),κ(x,z)=g(x)κ1(x,z)g(z)\kappa(\mathbf{x},\mathbf{z})=g(\mathbf{x})\kappa_1(\mathbf{x},\mathbf{z})g(\mathbf{z}) 也是核函数。

C-SVC算法

C-SVC算法:受参数 CC 的制约。

  • 参数 CC 是最小的训练误差和最大的分类间隔的折中。
  • 常用交叉验证法选取 CC。

给定大小为 mm 的训练集 DD,其中每个样本具有 nn 个属性,对应一个标签 yi∈{+1,−1}y_i\in\{+1,-1\} 表示其分类。

  • +1+1 表示正例
  • −1-1 表示负例

超平面方程表示为:

wTx+b=0w^T\mathbf{x}+b=0

对每一个样本 xi\mathbf{x}_i,引入一个松弛变量 ξ≥0\xi\geq 0,作为错误分类误差的度量,可以被认为是在分类错误的情况下样本与属于它的间隔边界超平面的距离。

  • 如果分类正确,该变量为0。

ξi={0,如果 yi(wTxi+b)≥+11−yi(wTxi+b),如果 yi(wTxi+b)≤+1\xi_i=\begin{cases}0,&如果\ y_i(w^T\mathbf{x}_i+b)\geq +1\\ 1-y_i(w^T\mathbf{x}_i+b),&如果\ y_i(w^T\mathbf{x}_i+b)\leq +1 \end{cases}

由上式得到原公式下实现软间隔最大化的约束条件:

yi(wTxi+b)≥1−ξi, ξi≥0, i=1,2,…,my_i(w^T\mathbf{x}_i+b)\geq 1-\xi_i,\ \xi_i\geq 0,\ i=1,2,\ldots,m

如下图 H1H_1 和 H2H_2 之间的间隔称为软间隔:

软间隔

在软间隔最大化中,被软间隔分隔错误的样本应该受到惩罚,且随着 ξi\xi_i 增大而增加。还要尽可能减少错误分隔的样本数。软间隔最大化原公式如下:

min⁡12∣∣w∣∣2+C∑i=1mξi同时保证 yi(wTxi+b)≥1−ξi, ξi≥0,i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2+C\sum_{i=1}^m\xi_i\\ 同时保证\ y_i(w^T\mathbf{x}_i+b)\geq 1-\xi_i,\ \xi_i\geq 0,i=1,2,\ldots,m

  • CC 为非负的惩罚参数,用于对分类错误样本的一定程度上的惩罚。
    • CC 大,相当于错误惩罚力度大。达到一定程度从而没有错误分类的样本,软间隔最大化等价于硬间隔最大化。
    • CC 小,相当于错误惩罚力度小。可能有更多样本被软间隔分类错误。
  • ∑i=1mξi\sum_{i=1}^m\xi_i 为分类错误的总量。

对其进行构造拉格朗日方程:

L(w,b,α,ξ,μ)=12∣∣w∣∣2+∑i=1mαi(1−yi(wTxi+b))+∑i=1m(C−αi−μi)ξiL(w,b,\mathcal{\alpha},\xi,\mu)=\frac{1}{2}\vert\vert w\vert\vert^2+\sum_{i=1}^m\alpha_i(1-y_i(w^T\mathbf{x}_i+b))+\sum_{i=1}^m(C-\alpha_i-\mu_i)\xi_i

也求偏导得到

∂L(w,b,α,ξ,μ)∂w=w−∑i=1mαiyixi=0⇒w=∑i=1mαiyixi\frac{\partial L(w,b,\mathcal{\alpha},\xi,\mu)}{\partial w}=w-\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i=0\Rightarrow w=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i

∂L(w,b,α,ξ,μ)∂b=−∑i=1mαiyi=0⇒0=∑i=1mαiyi\frac{\partial L(w,b,\mathcal{\alpha},\xi,\mu)}{\partial b}=-\sum_{i=1}^m\alpha_iy_i=0\Rightarrow 0=\sum_{i=1}^m\alpha_iy_i

∂L(w,b,α,ξ,μ)∂ξi=C−αi−μi=0\frac{\partial L(w,b,\mathcal{\alpha},\xi,\mu)}{\partial \xi_i}=C-\alpha_i-\mu_i=0

最后通过偏导式、拉格朗日方程、原公式得到软间隔对偶优化问题:

max⁡α−12∑i=1m∑j=1mαiαjyiyjxiTxj+∑i=1mαi同时保证 ∑i=1mαiyi=0和0≤αi≤C, i=1,2,…,m\max_\alpha-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jy_iy_j\mathbf{x}_i^T\mathbf{x}_j+\sum_{i=1}^m\alpha_i\\ 同时保证\ \sum_{i=1}^m\alpha_iy_i=0和0\leq\alpha_i\leq C,\ i=1,2,\ldots,m

KTT 条件:

αi(yi(wTxi+b)−1+ξi)=0, (C−αi)ξi=0, i=1,2,…,m\alpha_i(y_i(w^T\mathbf{x}_i+b)-1+\xi_i)=0,\ (C-\alpha_i)\xi_i=0,\ i=1,2,\ldots,m

  • ξi=0, αi=0\xi_i=0,\ \alpha_i=0:样本被正确分类,并且这些样本不是支持向量,不影响最终解。
  • ξi=0, 0<αi<C\xi_i=0,\ 0<\alpha_i<C:样本在间隔超平面上,即这些向量是支持向量。
  • 0<ξi≤1, αi=C0<\xi_i\leq1,\ \alpha_i=C:表示样本被分割超平面正确分类,但落在软间隔内。
  • ξi>1, αi=C\xi_i>1,\ \alpha_i=C:样本被错误分类。

设 α∗=(α1∗,α2∗,…,αm∗)\alpha^*=(\alpha_1^*,\alpha_2^*,\ldots,\alpha_m^*) 为解,得到分隔超平面的法向量 w∗w^* 为:

w∗=∑i=1mαi∗yixiw^*=\sum_{i=1}^m\alpha_i^*y_i\mathbf{x}_i

然后通过 αi(yi(wTxi+b)−1+ξi)=0, (C−αi)ξi=0, i=1,2,…,m\alpha_i(y_i(w^T\mathbf{x}_i+b)-1+\xi_i)=0,\ (C-\alpha_i)\xi_i=0,\ i=1,2,\ldots,m 计算 bb,并把它的平均值作为分隔超平面的偏移量 b∗b^*,则最终的决策函数为:

f(x)=sgn(∑i=1mαi∗yiK(xi⋅x)+b∗)f(\mathbf{x})=\mathbf{sgn}\left(\sum_{i=1}^m\alpha_i^*y_iK(\mathbf{x}_i\cdot\mathbf{x})+b^*\right)

ν-SVC 算法

使用参数 ν\nu 代替参数 CC。

  • 表示支持向量占全部训练样本的比例下限;
  • 也表示错误分类样本占全部训练样本的比例上限。
  • 如 ν=0.05\nu=0.05,则保证最多有5%的训练样本被错分类,且至少有5%的支持向量。

用常系数 ν\nu 代替参数 CC,同时还引入一个需要被优化的变量 ρ\rho,ν-SVC 的原公式:

min⁡12∣∣w∣∣2−νρ+1m∑i=1mξi同时保证 yi(wTxi+b)≥ρ−ξi和ξi≥0,ρ≥0,i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2-\nu\rho+\frac{1}{m}\sum_{i=1}^m\xi_i\\ 同时保证\ y_i(w^T\mathbf{x}_i+b)\geq\rho-\xi_i和\xi_i\geq 0,\rho\geq 0,i=1,2,\ldots,m

ν-SVC 的软间隔宽度为:2ρ/∣∣w∣∣2\rho/\vert\vert w\vert\vert。

拉格朗日方程:

L(w,b,α,ξ,μ,ρ,δ)=12∣∣w∣∣2−νρ+1m∑i=1mξi−∑i=1mα[yi(wTxi+b)−ρ+ξi]−∑i=1mμξi−δρL(w,b,\mathcal{\alpha},\xi,\mu,\rho,\delta)=\frac{1}{2}\vert\vert w\vert\vert^2-\nu\rho+\frac{1}{m}\sum_{i=1}^m\xi_i-\sum_{i=1}^m\alpha[y_i(w^T\mathbf{x}_i+b)-\rho+\xi_i]-\sum_{i=1}^m\mu\xi_i-\delta\rho

再次求偏导,使导数为0,得到:

w=∑i=1mαiyixiw=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i

αi+μi=1m\alpha_i+\mu_i=\frac{1}{m}

∑i=1mαiyi=0\sum_{i=1}^m\alpha_iy_i=0

∑i=1mαi−δ=0\sum_{i=1}^m\alpha_i-\delta=0

结合,最终得到二次优化问题:

max⁡α−12∑i=1m∑j=1mαiαjyiyjK(xi,xj)同时保证 ∑i=1mαiyi=0,0≤αi≤1m和∑i=1mαi≥ν, i=1,2,…,m\max_\alpha-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jy_iy_jK(x_i,x_j)\\ 同时保证\ \sum_{i=1}^m\alpha_iy_i=0,0\leq\alpha_i\leq\frac{1}{m}和\sum_{i=1}^m\alpha_i\geq\nu,\ i=1,2,\ldots,m

常系数 ν\nu 仍需满足:

ν≤2min⁡(Nums(yi=+1),Nums(yi=−1))m\nu\leq\frac{2\min(\mathbf{Nums}(y_i=+1),\mathbf{Nums}(y_i=-1))}{m}

  • Nums(yi=+1)\mathbf{Nums}(y_i=+1) 表示样本中正例数量。
  • Nums(yi=−1)\mathbf{Nums}(y_i=-1) 表示样本中负例数量。

决策函数为:

f(x)=sgn(∑i=1mαi∗yiK(xi,x)+b∗)f(\mathbf{x})=\mathbf{sgn}\left(\sum_{i=1}^m\alpha_i^*y_iK(\mathbf{x}_i,\mathbf{x})+b^*\right)

w=∑i=1mαiyixiw=\sum_{i=1}^m\alpha_iy_i\mathbf{x}_i

设两个集合 S+S_+ 和 S−S_-,集合内分别为正例和负例的支持向量(ξi=0\xi_i=0),元素数量都为 ss。约束变成 yif(xi)=ρy_if(\mathbf{x}_i)=\rho。得到 b∗b^* 和 ρ∗\rho^*:

b∗=−12s∑x∈S+∪S−∑i=1mαi∗yiK(x,xi)b^*=-\frac{1}{2s}\sum_{x\in S_+\cup S_-}\sum_{i=1}^m\alpha_i^*y_iK(\mathbf{x},\mathbf{x}_i)

ρ∗=12s(∑x∈S+∑i=1mαi∗yiK(x,xi)−∑x∈S−∑i=1mαi∗yiK(x,xi))\rho^*=\frac{1}{2s}\left(\sum_{x\in S_+}\sum_{i=1}^m\alpha_i^*y_iK(\mathbf{x},\mathbf{x}_i)-\sum_{x\in S_-}\sum_{i=1}^m\alpha_i^*y_iK(\mathbf{x},\mathbf{x}_i)\right)

多类问题的 SVC

处理多类问题时,把多个类转化为若干个问题处理。

一对其余:用一类与其余类进行比较。

  • 如将类1作为正例,其他组合一起作为负例,得到决策函数 f1(x)f_1(\mathbf{x});然后将类2作为正例,其余组合一起作为负例,得到决策函数 f2(x)f_2(\mathbf{x})。以此类推得到 kk 个决策函数。
  • 当对新样本 x\mathbf{x},带入下式得到分类:

arg⁡max⁡ifi(x)\arg\max_{i}f_i(\mathbf{x})

一对一:一共得到 k(k−1)/2k(k-1)/2 个决策函数 fi,j(x),0≤i<j≤kf_{i,j}(\mathbf{x}),0\leq i<j\leq k,表示第 ii 类和第 jj 类比较得到的决策函数。

  • 当对新样本 x\mathbf{x},需要代入所有的 fi,j(x)f_{i,j}(\mathbf{x}),统计所有类别的胜出次数,得票最多的类即为结果。

单类 SVM

单类问题并不是进行分类,而是判断新样本是否属于该类。

如判断银行业务中是否为欺诈交易时,无法提供足够多的欺诈例子用于训练,但有大量正常交易用于建模。

解决方法:Tax & Duin 法和 Schölkopf 法。


Tax & Duin 法:在输入空间或特征空间内找到一个体积最小的超球体,能够包含全部训练样本。
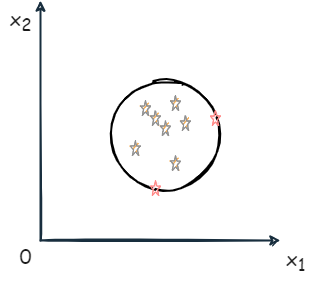
超球体

  • 当然也为每个样本 xi\mathbf{x}_i 分配一个松弛变量 ξi\xi_i

带有 ξi\xi_i、球心为 a\mathbf{a}、半径为 R\mathbf{R} 的超球体表达式为:

F(R,a,ξi)=R2+C∑i=1mξiF(\mathbf{R},\mathbf{a},\xi_i)=\mathbf{R}^2+C\sum_{i=1}^m\xi_i

  • CC 是常数,用于平衡超球体的体积大小和超球体外样本的数量。

使得上式最小化,还需满足约束:

∣∣ϕ(xi)−a∣∣2≤R2+ξi,ξi≥0,i=1,2,…,m\vert\vert\phi(\mathbf{x}_i)-\mathbf{a}\vert\vert^2\leq\mathbf{R}^2+\xi_i,\xi_i\geq 0, i=1,2,\ldots,m

  • ϕ(xi)\phi(\mathbf{x}_i) 表示样本 xi\mathbf{x}_i 从输入空间到特征空间的映射。

拉格朗日乘子法得到:

L(R,a,α,ξ,μ)=R2+C∑i=1mξi−∑i=1mαi[R2+ξi−∣∣ϕ(xi)−a∣∣2]−∑i=1mμiξiL(\mathbf{R},\mathbf{a},\alpha,\xi,\mu)=\mathbf{R}^2+C\sum_{i=1}^m\xi_i-\sum_{i=1}^m\alpha_i\left[\mathbf{R}^2+\xi_i-\vert\vert\phi(\mathbf{x}_i)-\mathbf{a}\vert\vert^2\right]-\sum_{i=1}^m\mu_i\xi_i

  • αi\alpha_i 和 μi\mu_i 都不小于0。

基于变量 R\mathbf{R}、a\mathbf{a}、ξi\xi_i 的偏导数分别为:

∑i=1mαi=1\sum_{i=1}^m\alpha_i=1

a=∑i=1mαiϕ(xi)\mathbf{a}=\sum_{i=1}^m\alpha_i\phi(\mathbf{x}_i)

C−αi−μi=0C-\alpha_i-\mu_i=0

通过代入得到对偶公式:

L(R,a,α,ξ,μ)=∑i=1mαiϕ(xi)⋅ϕ(xi)−∑i=1m∑j=1mαiαjϕ(xi)⋅ϕ(xj)L(\mathbf{R},\mathbf{a},\alpha,\xi,\mu)=\sum_{i=1}^m\alpha_i\phi(\mathbf{x}_i)\cdot\phi(\mathbf{x}_i)-\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_j\phi(\mathbf{x}_i)\cdot\phi(\mathbf{x}_j)

使用核函数代替点乘,得到二次优化问题:

max⁡α∑i=1mαiK(xi,xi)−∑i=1m∑j=1mαiαjK(xi,xj)受限于∑i=1mαi=1, 0≤αi≤C,i=1,2,…,m\max_\alpha\sum_{i=1}^m\alpha_iK(\mathbf{x}_i,\mathbf{x}_i)-\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_jK(\mathbf{x}_i,\mathbf{x}_j)\\ 受限于\sum_{i=1}^m\alpha_i=1,\ 0\leq\alpha_i\leq C, i=1,2,\ldots,m

在超球体表面的样本为支持向量。

  • 超球体的半径 R\mathbf{R} 可通过计算球心 a\mathbf{a} 到任意一个支持向量的距离得到。

设解为 α∗=(α1∗,α2∗,⋯+αm∗)\alpha^*=(\alpha_1^*,\alpha_2^*,\cdots+\alpha_m^*),支持向量为 xs\mathbf{x}_s :

R2=∣∣ϕ(xj)−a∣∣∣2=∣∣ϕ(xs)−∑i=1mαi∗ϕ(xi)2∣∣=K(xs,xs)−2∑i=1mαi∗K(xs,xs)+∑i=1m∑j=1mαi∗αj∗K(xi,xj)\mathbf{R}^2=\vert\vert\phi(\mathbf{x}_j)-\mathbf{a}\vert\vert\vert^2\\ =\vert\vert\phi(\mathbf{x}_s)-\sum_{i=1}^m\alpha_i^*\phi(\mathbf{x}_i)^2\vert\vert\\ =K(\mathbf{x}_s,\mathbf{x}_s)-2\sum_{i=1}^m\alpha_i^*K(\mathbf{x}_s,\mathbf{x}_s)+\sum_{i=1}^m\sum_{j=1}^m\alpha_i^*\alpha_j^*K(\mathbf{x}_i,\mathbf{x}_j)

当判断样本是否属于该类时,需要计算样本 x\mathbf{x} 与球心的距离 aa,并与半径 R\mathbf{R} 比较,如果小于半径,则是该类,否则不属于该类。

决策函数:

f(x)=sgn(d(x))f(x)=\mathbf{sgn}(d(\mathbf{x}))

f(x)=sgn(R2−K(x,x)+2∑i=1mαi∗K(xi,x)−∑i=1m∑j=1mαi∗αj∗K(xi,xj))=sgn(K(xs,xs)−K(x,x)−2∑i=1mαi∗[K(xi,xs)−K(xi,x)])\begin{aligned} f(x)&=\mathbf{sgn}\left(\mathbf{R}^2-K(\mathbf{x},\mathbf{x})+2\sum_{i=1}^m\alpha_i^*K(\mathbf{x}_i,\mathbf{x})-\sum_{i=1}^m\sum_{j=1}^m\alpha_i^*\alpha_j^*K(\mathbf{x}_i,\mathbf{x}_j)\right)\\ &=\mathbf{sgn}\left(K(\mathbf{x}_s,\mathbf{x}_s)-K(\mathbf{x},\mathbf{x})-2\sum_{i=1}^m\alpha_i^*[K(\mathbf{x}_i,\mathbf{x}_s)-K(\mathbf{x}_i,\mathbf{x})]\right) \end{aligned}

  • xs\mathbf{x}_s 表示任意一个支持向量;
  • 当 f(x)=1f(\mathbf{x})=1,表示 x\mathbf{x} 属于该类。

Schölkopf 法:在特征空间找到一个超平面,该超平面能够分隔全部样本和坐标原点,并且要使该超平面到远点的距离最远。

Schölkopf法的超平面

求解:

min⁡12∣∣w∣∣2+1νm∑i=1mξi−ρ受限于 (w⋅ϕ(xi))≥ρ−ξi,ξi≥0,i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2+\frac{1}{\nu m}\sum_{i=1}^m\xi_i-\rho\\ 受限于\ (w\cdot\phi(\mathbf{x}_i))\geq\rho-\xi_i,\xi_i\geq 0,i=1,2,\ldots,m

  • ν\nu 表示支持向量占全部训练样本的比例下限,也表示错误分类样本占全部训练样本的比例上限。

做拉格朗日方程:

L(w,ξ,ρ,α,μ)=12∣∣w∣∣2+1νm∑i=1mξi−ρ−∑i=1mαi(w⋅ϕ(xi)−ρ+ξi)−∑i=1mμiξiL(w,\xi,\rho,\alpha,\mu)=\frac{1}{2}\vert\vert w\vert\vert^2+\frac{1}{\nu m}\sum_{i=1}^m\xi_i-\rho-\sum_{i=1}^m\alpha_i(w\cdot\phi(\mathbf{x}_i)-\rho+\xi_i)-\sum_{i=1}^m\mu_i\xi_i

对 w、ξ、ρw、\xi、\rho 求偏导,使其为0,有:

w=∑i=1mαiϕ(xi)w=\sum_{i=1}^m\alpha_i\phi(\mathbf{x}_i)

αi=1νm−μi⇒αi≤1νm\alpha_i=\frac{1}{\nu m}-\mu_i\Rightarrow\alpha_i\leq\frac{1}{\nu m}

∑i=1mαi=1\sum_{i=1}^m\alpha_i=1

则对偶问题为:

max⁡α−12∑i=1m∑j=1mαiαiK(xi,xj)受限于 ∑i=1mαi=1,0≤αi≤1νm,i=1,2,…,m\max_{\alpha}-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m\alpha_i\alpha_iK(\mathbf{x}_i,\mathbf{x}_j)\\ 受限于\ \sum_{i=1}^m\alpha_i=1,0\leq\alpha_i\leq\frac{1}{\nu m},i=1,2,\ldots,m

设解为 α∗=(α1∗,α2∗,⋯ ,αm∗)\alpha^*=(\alpha_1^*,\alpha_2^*,\cdots,\alpha_m^*),若 αi\alpha_i 和 μi\mu_i 都不为0,则 ξi\xi_i 必为0:

ρ=(w⋅ϕ(xs))\rho=(w\cdot\phi(\mathbf{x}_s))

  • xs\mathbf{x}_s 为任意一个支持向量。

由 αj\alpha_j 不为0,代入 w=∑i=1mαiϕ(xi)w=\sum_{i=1}^m\alpha_i\phi(\mathbf{x}_i),则:

ρ=(w⋅ϕ(xs))=∑i=1mαiK(xi,xs)\rho=(w\cdot\phi(\mathbf{x}_s))=\sum_{i=1}^m\alpha_iK(\mathbf{x}_i,\mathbf{x}_s)

决策函数:

f(x)=sgn(d(x))=sgn((w⋅ϕ(x))−ρ)f(\mathbf{x})=\mathbf{sgn}(d(\mathbf{x}))=\mathbf{sgn}((w\cdot\phi(\mathbf{x}))-\rho)

f(x)=sgn(∑i=1mαi∗K(xi,x)−∑i=1mαi∗K(xi,xs))f(\mathbf{x})=\mathbf{sgn}\left(\sum_{i=1}^m\alpha_i^*K(\mathbf{x}_i,\mathbf{x})-\sum_{i=1}^m\alpha_i^*K(\mathbf{x}_i,\mathbf{x}_s)\right)

  • xs\mathbf{x}_s 为任意一个支持向量。
  • x\mathbf{x} 为待预测样本。
  • 当 f(x)=1f(\mathbf{x})=1,表示 x\mathbf{x} 属于该类。

ε-SVR 算法

Vapnik 通过 ε\varepsilon 不敏感损失函数,把 SVM 扩展到回归问题中。

设 yiy_i 为样本 x\mathbf{x} 对应的响应值,回归问题则是找到一个函数 f(x)f(\mathbf{x}),使得 f(xi)=yif(\mathbf{x}_i)=y_i。

  • 估计的质量好坏由不敏感损失函数衡量。

Lossε={0,如果∣y−f(x)≤ε∣y−f(x)∣−ε,其他\mathbf{Loss}_\varepsilon=\begin{cases}0,& 如果\vert y-f(\mathbf{x})\leq\varepsilon\\\vert y-f(\mathbf{x})\vert-\varepsilon,& 其他\end{cases}

  • ε>0\varepsilon>0,表示控制误差限度的常量,即如果误差在 [−ε,ε][-\varepsilon,\varepsilon] 之间,就认为忽略误差。

线性关系时,函数表示为:

f(x)=w⋅x+bf(\mathbf{x})=w\cdot\mathbf{x}+b

  • ww 为权重,bb 为偏置。

一维线性SVR

由于误差允许,所以在 f(x)f(\mathbf{x}) 周围形成一个包围,称之为 ε\varepsilon 管。

ε\varepsilon-SVR 中,得到 f(x)f(\mathbf{x}) 还需要满足:

  1. 使 f(x)f(\mathbf{x}) 与测量值 yiy_i 的偏差值不大于 ε\varepsilon,让所有样本都在 ε\varepsilon 管中。
  2. 使 f(x)f(\mathbf{x}) 尽可能平坦,简化模型,能够避免过拟合。平直指的是样本中各个特征属性对样本贡献大小应该均衡,即 ww 要小。

ε\varepsilon-SVR 问题表示为:

min⁡12∣∣w∣∣2受限于{yi−w⋅xi−b≤εw⋅xi+b−yi≤ε,i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2\\ 受限于\begin{cases}y_i-w\cdot \mathbf{x}_i-b\leq\varepsilon\\ w\cdot\mathbf{x}_i+b-y_i\leq\varepsilon\end{cases},i=1,2,\ldots,m

也使用软间隔,引入两个松弛变量 ξ+\xi^+ 和 ξ−\xi^-,上式改写为:

  • ξi+\xi_i^+ 表示那些被高估的样本响应值的误差;
  • ξi−\xi_i^- 表示那些被低估的样本响应值的误差

min⁡12∣∣w∣∣2+C∑i=1m(ξi++ξi−)受限于{yi−w⋅xi−b≤ε+ξi−w⋅xi+b−yi≤ε+ξi+, {ξi−≥0ξi+≥0, i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2+C\sum_{i=1}^m(\xi_i^++\xi_i^-)\\ 受限于\begin{cases}y_i-w\cdot \mathbf{x}_i-b\leq\varepsilon+\xi_i^-\\ w\cdot\mathbf{x}_i+b-y_i\leq\varepsilon+\xi_i^+\end{cases},\ \begin{cases}\xi_i^-\geq 0\\\xi_i^+\geq 0\end{cases},\ i=1,2,\ldots,m

  • C>0C>0:为常数,均衡 f(x)f(\mathbf{x}) 的平坦程度与偏差大于 ε\varepsilon 的样本数量。

∣ξ∣ε={0,如果∣ξ∣≤ε∣ξ∣−ε,其他\vert\xi\vert_\varepsilon=\begin{cases}0,& 如果\vert\xi\vert\leq\varepsilon\\\vert\xi\vert-\varepsilon,& 其他\end{cases}

表示改写后的拉格朗日乘子法方程为:

L(w,b,ξ,α,μ)=12∣∣w∣∣2+C∑i=1m(ξi++ξi−)−∑i=1m(μi+ξi++μi−ξi−)−∑i=1mαi+(ε+ξi++yi−w⋅xi−b)−∑i=1mαi−(ε+ξi−−yi+w⋅xi+b)L(w,b,\xi,\alpha,\mu)=\frac{1}{2}\vert\vert w\vert\vert^2+C\sum_{i=1}^m(\xi_i^++\xi_i^-)-\sum_{i=1}^m(\mu_i^+\xi_i^++\mu_i^-\xi_i^-)\\ -\sum_{i=1}^m\alpha_i^+(\varepsilon+\xi_i^++y_i-w\cdot\mathbf{x}_i-b)-\sum_{i=1}^m\alpha_i^-(\varepsilon+\xi_i^--y_i+w\cdot\mathbf{x}_i+b)

  • αi+、αi−、μi+、μi−\alpha_i^+、\alpha_i^-、\mu_i^+、\mu_i^- 都为非负值。

对原变量 w、b、ξw、b、\xi 进行求偏导并使其为0:

∂L∂w=w−∑i=1m(αi−−αi+)xi=0⇒w=∑i=1m(αi−−αi+)xi\frac{\partial L}{\partial w}=w-\sum_{i=1}^m(\alpha_i^--\alpha_i^+)\mathbf{x}_i=0\Rightarrow w=\sum_{i=1}^m(\alpha_i^--\alpha_i^+)\mathbf{x}_i

∂L∂b=∑i=1m(αi+−αi−)=0\frac{\partial L}{\partial b}=\sum_{i=1}^m(\alpha_i^+-\alpha_i^-)=0

∂L∂ξ+=C−μi+−αi+=0\frac{\partial L}{\partial \xi^+}=C-\mu_i^+-\alpha_i^+=0

∂L∂ξ−=C−μi−−αi−=0\frac{\partial L}{\partial \xi^-}=C-\mu_i^--\alpha_i^-=0

进入代入,得到对偶优化问题:

max⁡α−,α+−12∑i=1m∑j=1m(αi−−αi+)(αj−−αj+)K(xi,xj)−ε∑i=1m(αi−+αi+)+∑i=1myi(αi−−αi+)受限于 ∑i=1m(αi−−αi+)=0, αi−,αj+∈[0,C]\max_{\alpha^-,\alpha^+}-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m(\alpha_i^--\alpha_i^+)(\alpha_j^--\alpha_j^+)K(\mathbf{x}_i,\mathbf{x}_j)-\varepsilon\sum_{i=1}^m(\alpha_i^-+\alpha_i^+)+\sum_{i=1}^my_i(\alpha_i^--\alpha_i^+)\\ 受限于\ \sum_{i=1}^m(\alpha_i^--\alpha_i^+)=0,\ \alpha_i^-,\alpha_j^+\in[0,C]

  • K(xi,xj)K(\mathbf{x}_i,\mathbf{x}_j):为核函数,同前映射关系。

设解为 α∗=(α1−∗,α1+∗,⋯ ,αm−∗,αm+∗)\alpha^*=(\alpha_1^{-*},\alpha_1^{+*},\cdots,\alpha_m^{-*},\alpha_m^{+*}),则:

w=∑i=1m(αi−∗−αi+∗)ϕ(xi)w=\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})\phi(\mathbf{x}_i)

最后回归计算公式:

f(x)=∑i=1m(αi−∗−αi+∗)K(xi,x)+b∗f(\mathbf{x})=\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x})+b^*

由 KKT 条件计算:

b∗=yj−∑i=1m(αi−∗−αi+∗)K(xi,xj)+εb^*=y_j-\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x}_j)+\varepsilon

或

b∗=yk−∑i=1m(αi−∗−αi+∗)K(xi,xk)−εb^*=y_k-\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x}_k)-\varepsilon

  • (xj,yj)(\mathbf{x}_j,y_j) 为任意一个样本对应的 αj+∗∈(0,C)\alpha_j^{+*}\in(0,C);
  • (xk,yk)(\mathbf{x}_k,y_k) 为任意一个样本对应的 αk−∗∈(0,C)\alpha_k^{-*}\in(0,C)。

由 KKT 条件,还可以知道 αi−∗\alpha_i^{-*} 或 αi+∗\alpha_i^{+*} 等于 CC 的样本在 ε\varepsilon 管外,而且 αi−∗\alpha_i^{-*} 或 αi+∗\alpha_i^{+*} 不可能同时为0。

这意味着一个样本不能拥有两个方向的松弛变量 ξ\xi,只能向一个方向偏离。

ν-SVR 算法

Schölkopf 从 ν-SVC 算法上扩展得到 ν-SVR 算法。

ν-SVR 原公式:

min⁡12∣∣w∣∣2+C(νε+1m∑i=1m(ξi++ξi−))受限于 {yi−w⋅ϕ(xi)−b≤ε+ξi−w⋅ϕ(xi)+b−yi≤ε+ξi+, {ξi−≥0ξi+≥0, i=1,2,…,m\min\frac{1}{2}\vert\vert w\vert\vert^2+C\left(\nu\varepsilon+\frac{1}{m}\sum_{i=1}^m(\xi_i^++\xi_i^-)\right)\\ 受限于\ \begin{cases}y_i-w\cdot\phi(\mathbf{x}_i)-b\leq\varepsilon+\xi_i^-\\ w\cdot\phi(\mathbf{x}_i)+b-y_i\leq\varepsilon+\xi_i^+\end{cases},\ \begin{cases}\xi_i^-\geq 0\\\xi_i^+\geq 0\end{cases},\ i=1,2,\ldots,m

ε\varepsilon-SVR 中,参数 ε\varepsilon 通过经验选取,而在 ν\nu-SVR 中把 ε\varepsilon 作为目标函数的一个变量。同时 CC 和 ν\nu 为常数, CC 为正值; ν∈[0,1]\nu\in[0,1] 同样表示支持向量占全部训练样本的比例下限,也表示错误估计样本占全部训练样本的比例上限。

取拉格朗日方程为:

L(w,b,β,ε,ξ,α,μ)=12+Cνε+Cm∑i=1m(ξi++ξi−)−βε−∑i=1m(μi+ξi++μi−ξi−)−∑i=1mαi+(ε+ξi++yi−w⋅ϕ(xi)−b)−∑i=1mαi−(ε+ξi−−yi+w⋅ϕ(xi)+b)L(w,b,\beta,\varepsilon,\xi,\alpha,\mu)=\frac{1}{2}+C\nu\varepsilon+\frac{C}{m}\sum_{i=1}^m(\xi_i^++\xi_i^-)-\beta\varepsilon-\sum_{i=1}^m(\mu_i^+\xi_i^++\mu_i^-\xi_i^-)\\ -\sum_{i=1}^m\alpha_i^+(\varepsilon+\xi_i^++y_i-w\cdot\phi(\mathbf{x}_i)-b)-\sum_{i=1}^m\alpha_i^-(\varepsilon+\xi_i^--y_i+w\cdot\phi(\mathbf{x}_i)+b)

对原变量 w、ε、b、ξw、\varepsilon、b、\xi 求偏导并使之为0:

∂L∂w=w−∑i=1m(αi−−αi+)ϕ(xi)=0⇒w=∑i=1m(αi−−αi+)ϕ(xi)\frac{\partial L}{\partial w}=w-\sum_{i=1}^m(\alpha_i^--\alpha_i^+)\phi(\mathbf{x}_i)=0\Rightarrow w=\sum_{i=1}^m(\alpha_i^--\alpha_i^+)\phi(\mathbf{x}_i)

∂L∂ε=Cν−∑i=1m(αi++αi−)−β=0\frac{\partial L}{\partial \varepsilon}=C\nu-\sum_{i=1}^m(\alpha_i^++\alpha_i^-)-\beta=0

∂L∂b=∑i=1m(αi+−αi−)=0\frac{\partial L}{\partial b}=\sum_{i=1}^m(\alpha_i^+-\alpha_i^-)=0

∂L∂ξ+=Cm−μi+−αi+=0\frac{\partial L}{\partial \xi^+}=\frac{C}{m}-\mu_i^+-\alpha_i^+=0

∂L∂ξ−=Cm−μi−−αi−=−β\frac{\partial L}{\partial \xi^-}=\frac{C}{m}-\mu_i^--\alpha_i^-=-\beta

进入代入,得到对偶优化问题:

max⁡α−,α+−12∑i=1m∑j=1m(αi−−αi+)(αj−−αj+)K(xi,xj)+∑i=1myi(αi−−αi+)受限于 ∑i=1m(αi−−αi+)=0, αi−,αj+∈[0,Cm], ∑i=1m(αi++αi−)≤Cν\max_{\alpha^-,\alpha^+}-\frac{1}{2}\sum_{i=1}^m\sum_{j=1}^m(\alpha_i^--\alpha_i^+)(\alpha_j^--\alpha_j^+)K(\mathbf{x}_i,\mathbf{x}_j)+\sum_{i=1}^my_i(\alpha_i^--\alpha_i^+)\\ 受限于\ \sum_{i=1}^m(\alpha_i^--\alpha_i^+)=0,\ \alpha_i^-,\alpha_j^+\in[0,\frac{C}{m}],\ \sum_{i=1}^m(\alpha_i^++\alpha_i^-)\leq C\nu

设解为 α∗=(α1−∗,α1+∗,⋯ ,αm−∗,αm+∗)\alpha^*=(\alpha_1^{-*},\alpha_1^{+*},\cdots,\alpha_m^{-*},\alpha_m^{+*}),则最后回归计算公式:

f(x)=∑i=1m(αi−∗−αi+∗)K(xi,x)+b∗f(\mathbf{x})=\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x})+b^*

由 KKT 条件得到:

b∗=12[yi+yk−∑i=1m(αi−∗−αi+∗)K(xi,xj)−∑i=1m(αi−∗−αi+∗)K(xi,xk)]b^*=\frac{1}{2}\left[y_i+y_k-\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x}_j)-\sum_{i=1}^m(\alpha_i^{-*}-\alpha_i^{+*})K(\mathbf{x}_i,\mathbf{x}_k)\right]

  • (xj,yj)(\mathbf{x}_j,y_j) 为任意一个样本对应的 αj+∗∈(0,C/N)\alpha_j^{+*}\in(0,C/N);
  • (xk,yk)(\mathbf{x}_k,y_k) 为任意一个样本对应的 αk−∗∈(0,C/N)\alpha_k^{-*}\in(0,C/N)

解 ε∗\varepsilon^* 为:

ε∗=∑i=1m(αi−−αi+)K(xi,xj)−yj+b∗\varepsilon^*=\sum_{i=1}^m(\alpha_i^--\alpha_i^+)K(\mathbf{x}_i,\mathbf{x}_j)-y_j+b^*

或

ε∗=yk−∑i=1m(αi−−αi+)K(xi,xj)−b∗\varepsilon^*=y_k-\sum_{i=1}^m(\alpha_i^--\alpha_i^+)K(\mathbf{x}_i,\mathbf{x}_j)-b^*

  • (xj,yj)(\mathbf{x}_j,y_j) 为任意一个样本对应的 αj+∗∈(0,C/N)\alpha_j^{+*}\in(0,C/N);
  • (xk,yk)(\mathbf{x}_k,y_k) 为任意一个样本对应的 αk−∗∈(0,C/N)\alpha_k^{-*}\in(0,C/N)

OpenCV所支持的 SVM

OpenCV 提供了五种支持向量机的类型,分别为:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
enum Types {
// C-SVC,n类分类(n≥2)
C_SVC=100,

// ν-SVC
NU_SVC=101,

// 单类SVM
ONE_CLASS=102,

// ε-SVR
EPS_SVR=103,

// ν-SVR
NU_SVR=104
};

通过 SVM::setType(int val) 设置 SVM 类型,默认为 C_SVC。通过 SVM::getType() 获取 SVM 类型。

各个类型的 SVM 的超参可以通过以下函数访问:

  • CC:通过 SVM::setC(double val) 和 SVM::getC() 访问。
  • ν\nu:通过 SVM::setNu(double val) 和 SVM::getNu() 访问。
  • ε\varepsilon:通过 SVM::setP(double val) 和 SVM::getP() 访问。

同时支持的核函数有:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
enum KernelTypes {
// 当自定义内核已设置时,由SVM::getKernelType返回
CUSTOM=-1,

// 线性核
LINEAR=0,

// 多项式核
POLY=1,

// 径向基函数(RBF),在大多数情况下是一个很好的选择。
RBF=2,

// Sigmoid 核函数
SIGMOID=3,

// 指数CHI2核,类似于RBF核
CHI2=4,

// 直方图相交核,比较快.
INTER=5
};

使用 SVM::setKernelType(int kernelType) 设置核函数类型。

  • 多项式核为:K(xi,xj)=(γxiTxj+coef0)degree, γ>0K(x_i, x_j) = (\gamma x_i^T x_j + \mathbf{coef0})^{\mathbf{degree}},\ \gamma > 0
  • 径向基函数 RBF:K(xi,xj)=e−γ∣∣xi−xj∣∣2, γ>0K(x_i, x_j) = e^{-\gamma ||x_i - x_j||^2},\ \gamma > 0
  • Sigmoid 函数:K(xi,xj)=tanh⁡(γxiTxj+coef0)K(x_i, x_j) = \tanh(\gamma x_i^T x_j + \mathbf{coef0})
  • 指数 CHI2 核:K(xi,xj)=e−γχ2(xi,xj), χ2(xi,xj)=(xi−xj)2/(xi+xj), γ>0K(x_i, x_j) = e^{-\gamma \chi^2(x_i,x_j)},\ \chi^2(x_i,x_j) = (x_i-x_j)^2/(x_i+x_j),\ \gamma > 0
  • 直方图相交核:K(xi,xj)=min(xi,xj)K(x_i, x_j) = min(x_i,x_j)

上述的超参:

  • γ\gamma:通过 SVM::setGamma(double val) 和 SVM::getGamma() 访问。
  • coef0\mathbf{coef0}:通过 SVM::setCoef0(double val) 和 SVM::getCoef0() 访问。
  • degree\mathbf{degree}:通过 SVM::setDegree(int val) 和 SVM::getDegree() 访问。

关于迭代设置函数:setTermCriteria(const cv::TermCriteria &val):

  • 该类变量需要3个参数:类型、迭代的最大次数、特定的阈值。
    • 类型:迭代的最大次数 TermCriteria::MAX_ITER 、特定的阈值(期望精度) TermCriteria::EPS 或 MAX_ITER + EPS。

还有关于 SVM::trainAuto(...),函数如下:

1
2
3
4
5
6
7
8
bool trainAuto( const Ptr<TrainData>& data, int kFold = 10,
ParamGrid Cgrid = getDefaultGrid(C),
ParamGrid gammaGrid = getDefaultGrid(GAMMA),
ParamGrid pGrid = getDefaultGrid(P),
ParamGrid nuGrid = getDefaultGrid(NU),
ParamGrid coeffGrid = getDefaultGrid(COEF),
ParamGrid degreeGrid = getDefaultGrid(DEGREE),
bool balanced=false) = 0;
  • 该方法通过选择最佳参数 CC、γ\gamma、pp、ν\nu、coef0\mathbf{coef0}、degree\mathbf{degree} 来自动训练 SVM 模型。当测试集误差的交叉验证估计值最小时,参数被认为是最佳的。
    • 如果不需要优化参数,则应将相应的网格步长设置为小于或等于1的任何值。
  • data:训练集;
  • kFold:交叉验证参数。训练集被划分为kFold子集。一个子集用于测试模型,其他子集形成训练集;
  • Cgrid:参数 CC 的网格;
  • gammaGrid:参数 γ\gamma 的网格;
  • pGrid:参数 ε\varepsilon 的网格;
  • nuGrid:参数 ν\nu 的网格;
  • coeffGrid:参数 coef0\mathbf{coef0} 的网格;
  • degreeGrid:参数 degree\mathbf{degree} 的网格;
  • balanced:如果为真且问题是 2 分类,则该方法创建更平衡的交叉验证子集,即子集中的类之间的比例接近整个训练数据集中的比例。

类似地,该函数重载还有:

1
2
3
4
5
6
7
8
9
10
11
bool trainAuto(InputArray samples,
int layout,
InputArray responses,
int kFold = 10,
Ptr<ParamGrid> Cgrid = SVM::getDefaultGridPtr(SVM::C),
Ptr<ParamGrid> gammaGrid = SVM::getDefaultGridPtr(SVM::GAMMA),
Ptr<ParamGrid> pGrid = SVM::getDefaultGridPtr(SVM::P),
Ptr<ParamGrid> nuGrid = SVM::getDefaultGridPtr(SVM::NU),
Ptr<ParamGrid> coeffGrid = SVM::getDefaultGridPtr(SVM::COEF),
Ptr<ParamGrid> degreeGrid = SVM::getDefaultGridPtr(SVM::DEGREE),
bool balanced=false) = 0;

例子-香蕉数据集

数据集地址:https://sci2s.ugr.es/keel/dataset.php?cod=182

该数据集十分简单,只有两个属性和一个标签。

  • 属性 At1 和 At2:分别对应于x轴和y轴的两个属性。
  • 标签 -1 和 +1:表示数据集中的两种香蕉形状之一。

部分数据如下表:

At1 At2 Class
0.174 1.92 -1.0
1.64 0.0477 -1.0
-0.478 -0.796 -1.0
-0.447 -1.0 -1.0
-1.04 -0.2 1.0
2.06 -0.482 -1.0

使用 OpenCV 提供的 SVM 模型效果如下:

1
2
3
4
5
Train Data imported: 5100
Test Data imported: 200
SVM算法(基于OpenCV实现):
计算花费时长:131ms
正确率:0.915

代码地址:Gitee - SVM